复现 LayoutLMv3 预训练:继续预训练带来了什么、没带来什么
LayoutLMv3 用三个目标做预训练:掩码语言建模(MLM)、掩码图像建模(MIM)和词-图块对齐(WPA)。微软发布了微调代码和模型权重,但没有发布预训练代码,社区里一直有人在问(unilm#733、#1042、#1609 等)。我在 Hugging Face transformers 之上写了一个小而带测试的复现:14H034160212/layoutlmv3-pretraining。它是根据论文独立实现的,不是微软的原始代码。
这篇文章讲的是用它对 microsoft/layoutlmv3-base 和 -large 做继续预训练时学到的东西。简单说:已发布的编码器是一个很强的起点,我的代码正确地在它的基础上训练,而额外加入最多 40 万页文档,只在 FUNSD 上带来很小的提升,在 CORD 上没有提升。
实现了什么
| 目标 | 论文 | 本仓库 |
|---|---|---|
| MLM | 掩盖 30% 的文本 token,span 长度服从 Poisson(3) | span 掩码,加上与词嵌入共享权重的 LM head |
| MIM | 按块掩盖 40% 的图块,预测文档 dVAE 给出的离散视觉 token | 按块掩码,掩盖的图块替换为可学习的 [MASK] 嵌入;目标来自 OpenAI 的 DALL-E dVAE(或 k-means 码本) |
| WPA | 对每个未被掩盖的文本 token,预测它对应的图块是否被掩盖 | 根据 token 的框在 14×14 图块网格上生成标签,两层 MLP head |
有一处差异是有意为之的:论文的 MIM 目标来自 DiT 的文档 dVAE,它从未公开,所以我用了公开的、在自然图像上训练的 DALL-E dVAE。输出是一个普通的 LayoutLMv3Model 权重,常用的任务 head 都能直接加载。
经验一:确认继续预训练到底从哪里出发
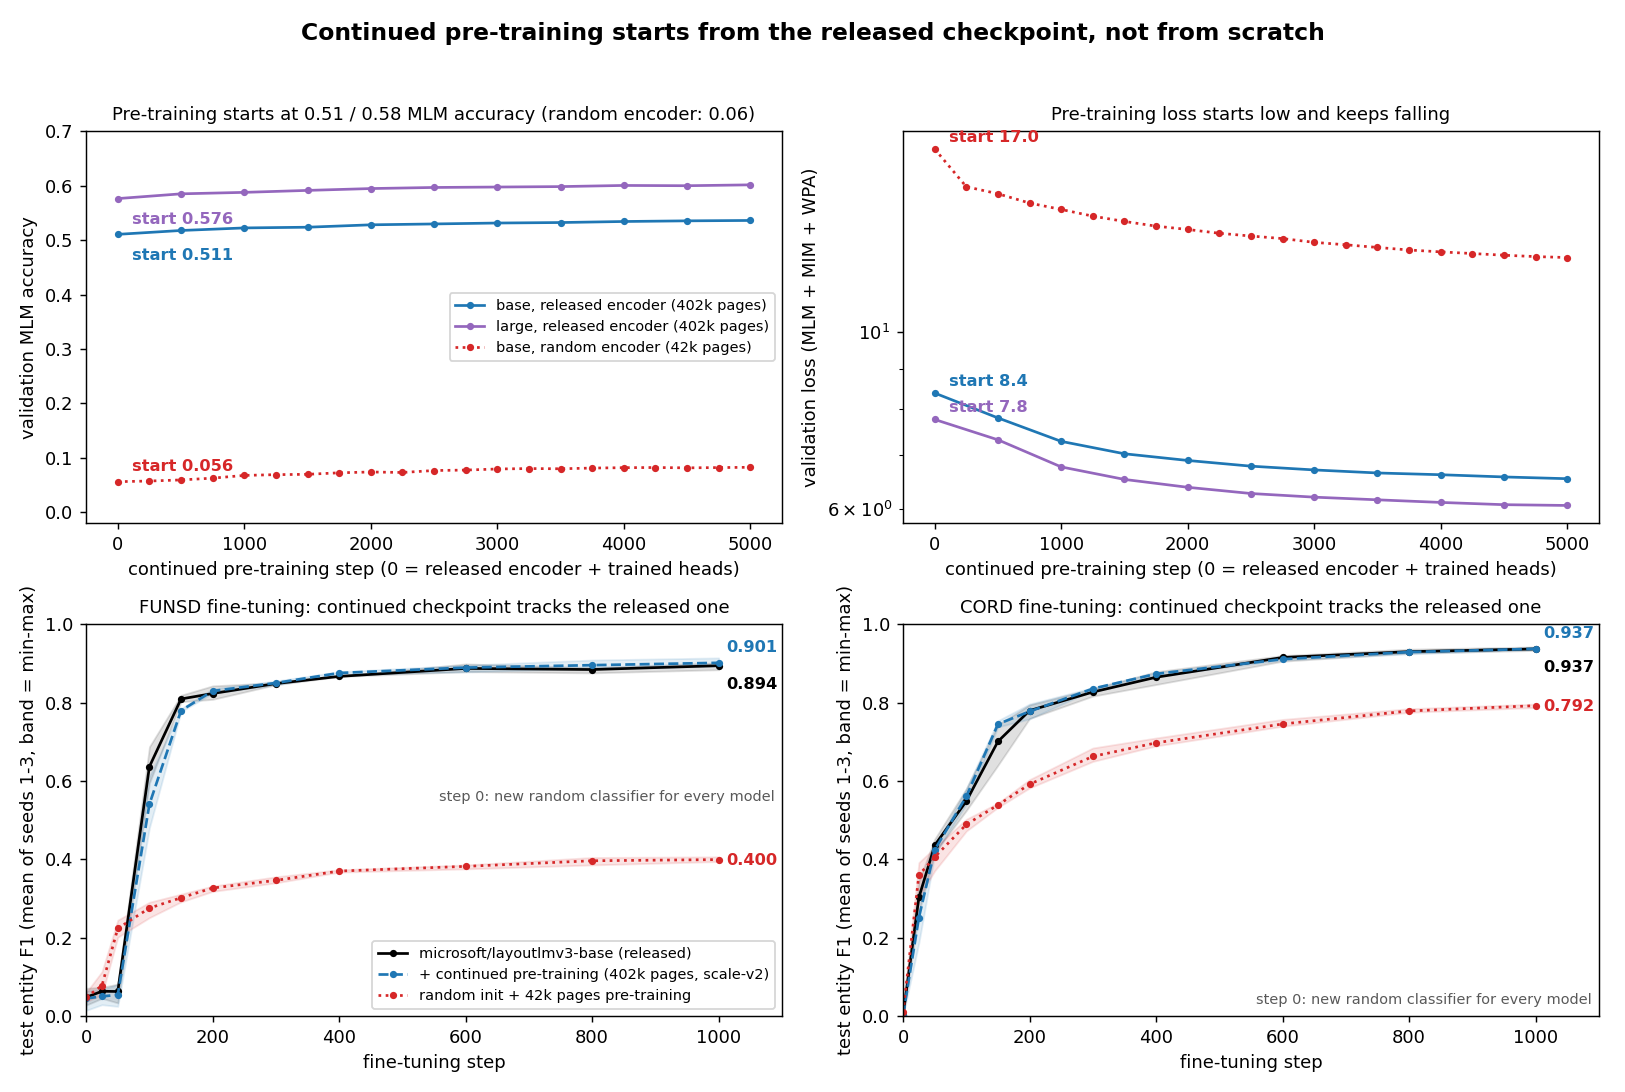
我的第一次训练看起来像是从零开始:第 0 步验证损失 24.8,MLM 准确率 0.00。原因是已发布的权重只包含编码器,MLM、MIM、WPA 三个 head 和图像 [MASK] 嵌入在第 0 步都是随机的,所以第 0 步的指标衡量的是随机 head,而不是编码器。而且从这里开始联合训练,随机 head 的梯度也会冲击已经预训练好的编码器。
解决办法是先预热 head:用 1,000 步只训练新增的参数,编码器保持冻结。我确认了预热后编码器与原始权重逐位相同,用它微调也得到与发布模型完全相同的 FUNSD 分数。这个预热顺便成了一个很有用的正确性检查:
| 冻结编码器,1,000 步只训练 head 之后 | MLM 准确率 | MIM 准确率 |
|---|---|---|
已发布的 layoutlmv3-base | 0.511 | 0.122 |
已发布的 layoutlmv3-large | 0.574 | 0.129 |
| 随机初始化的编码器,同样配置 | 0.056 | 0.039 |
一个新的 head 能从冻结的编码器里这么好地读出被掩盖的 token,前提是权重加载正确,而且输入流程(分词、0-1000 的段级框、span 掩码、图像归一化)与编码器预训练时看到的一致。这不能证明代码与微软的等价,但比一条从 24.8 开始的损失曲线可靠得多。它还揭示了第一次训练的真相:联合训练 6,000 步后的最终 MLM 准确率是 0.515,只比冻结编码器预热后的 0.511 高一点点。那条曲线的大部分其实是 head 在学习。
经验二:先规定什么算提升,再看结果
两个模型之间微调 F1 的配对差值,在不同随机种子之间的标准差大约是 0.75 个点,和我想测的效应一样大。所以每个实验开始之前,我都先把计划和决策规则提交到仓库。扩大数据规模那次的规则是:在 5 个种子 × 2 个任务上,配对平均提升至少 +0.5 个 F1 点,FUNSD 和 CORD 都为正,并且 p < 0.05。
| 初始化(base),5 个种子 | FUNSD F1 | CORD F1 |
|---|---|---|
microsoft/layoutlmv3-base | 0.895 ± 0.007 | 0.936 ± 0.004 |
| + 4.2 万页 IDL | 0.899 ± 0.004 | 0.933 ± 0.004 |
| + 40.2 万页 IDL | 0.900(+0.50,p = 0.25) | 0.939(+0.32,p = 0.28) |
数据量增加十倍后,预训练的验证损失明显下降(预热后 8.38,最佳步 6.21),MLM 和 MIM 准确率也更高,但下游没有达到预先规定的标准。用 10 个种子和更严格的评估,40.2 万页的模型在 FUNSD 上提升 +0.65 F1(p = 0.047,未做多重比较校正),在 CORD 上没有变化。这和数据的特点吻合:Industry Documents Library 里大多是表单和信件,与 FUNSD 相似,而 CORD 是收据。发布的模型本来就在大约 1,100 万页类似文档上预训练过,再加 40 万页通用文档只是很小的补充。针对目标任务的同领域数据看起来是更有希望的方向。
经验三:有些目标比看上去更容易"作弊"
WPA 很快就能达到 99% 的准确率,但这个数字意义不大:一个 token 的图块是否被掩盖,可以直接从可学习的 [MASK] 图块嵌入里读出来。如果让 head 同时看 token 覆盖的图块,这条捷径就很明显了:用随机编码器也能达到 AUC 1.000。我保留这个变体只是为了能复现这条捷径;报告 WPA 时用的是只看文本的 head 的平衡准确率和 AUC。在这种设置下,已发布的编码器用两层 MLP 得到 AUC 0.904,随机编码器最多 0.69,说明它确实包含对齐信息。
一次独立的代码审查还发现了三个数据流程的 bug:大约 10% 的页面图像相对 OCR 框是旋转的,12 个 DataLoader 进程生成了完全相同的掩码,以及断点续训会重放语料开头。每个都补了回归测试。修复后重跑 40 万页的实验,下游结果没有可测量的变化(p = 0.35),但不重跑是不会知道这一点的。
如何使用
pip install -e ".[dev]"
pytest tests
python scripts/pretrain.py --corpus idl --idl_shards 0-26 --exclude_funsd_test \
    --image_tokenizer dalle --head_warmup_steps 1000 --output_dir runs/idl_base
每次运行都会记录确切的命令、git 提交、配置和指标,新的运行也可以接入 Weights & Biases。请注意许可证:代码是 MIT,但 microsoft/layoutlmv3-* 的权重是 CC BY-NC-SA 4.0,在它们基础上继续训练得到的权重也继承这个许可。仓库里有 CITATION.cff,如果用到这份代码,请同时引用本仓库和 LayoutLMv3 原论文。
编写代码和撰写本文时,我使用了 Claude(Anthropic)辅助。设计和结果都经过我本人审阅,文中所有数字都来自仓库里的脚本和结果文件。
包启明,现居新西兰奥克兰的 AI 研究者,研究方向为大模型推理与模型部署。博士毕业于奥克兰大学 Strong AI Lab,参与 PyTorch ONNX 导出器、ONNX Runtime、ONNX Runtime GenAI 和 Microsoft PyRIT 等开源项目的贡献。